출간 예정 · 2026년 9월 출간 계약
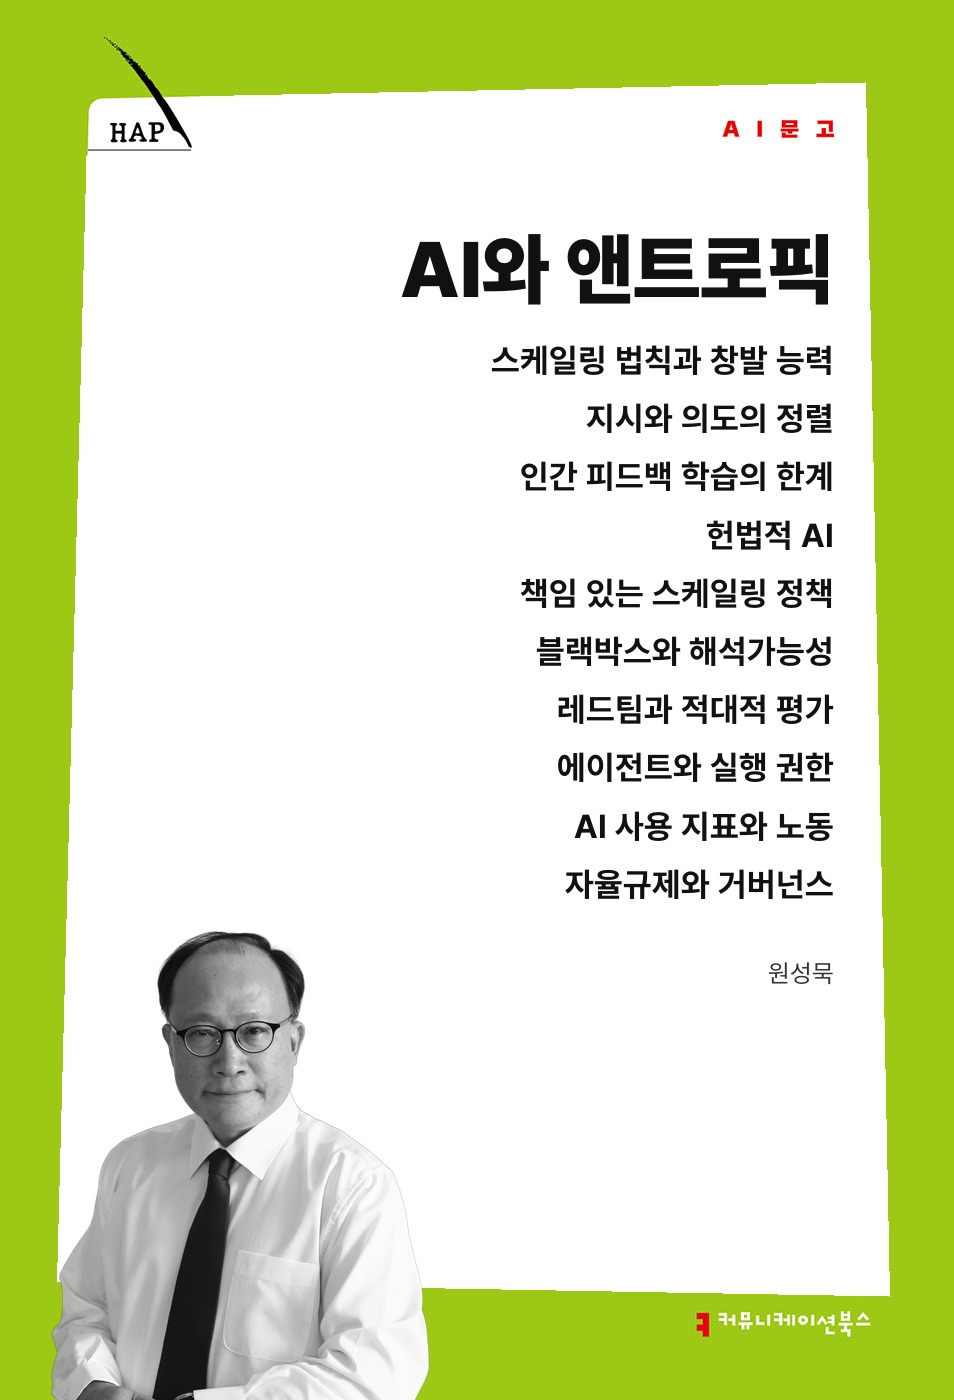
AI와 앤트로픽
커뮤니케이션북스 AI문고
AI를 매일 쓰면서도 그 도구가 어떤 원칙 위에서 움직이는지는 모르는 사람에게, AI 안전이 실제로 무엇을 가리키는지 알려주는 개념서. 헌법적 AI, 책임 있는 스케일링, 해석가능성 같은 열 가지 개념을 앤트로픽이 공개한 문서를 근거로 설명한다.
회사의 연대기가 아니라 개념을 설명하는 책이다. 개념마다 어떤 문제에서 나왔고, 무엇을 해결했으며, 무엇이 남았는지를 회사가 공개한 정책 문서·연구 발표·원논문으로 따진다.
서지정보
CONTENTS
목차 흐름
- 서문
괴물의 조련사
능력을 키우는 일과 통제하는 일이 한 조직 안에서 충돌하는 지점에서 출발해 열 개의 개념을 펼친다.
- 1장
스케일링 법칙과 창발 능력
스케일링 법칙이 예측하는 것과 예측하지 못하는 것, 그리고 예측되지 않는 능력이 안전 문제의 출발점이 되는 이유.
- 2장
지시와 의도의 정렬
지시를 따르는 것과 의도를 따르는 것의 차이, 정렬이 기술 용어이면서 가치 판단인 이유.
- 3장
인간 피드백 학습의 한계
사람의 선호로 모델을 다듬는 방식이 해결한 것과 평가자 편향·규모의 한계라는 대가.
- 4장
헌법적 AI
원칙 문서를 주고 모델이 스스로 답변을 고치게 하는 방식, 그 원칙은 누가 쓰는가.
- 5장
책임 있는 스케일링 정책
위험이 커지면 스스로 멈추겠다는 약속과 자기 구속이 실제로 작동하는 조건.
- 6장
블랙박스와 해석가능성
신경망 안에서 개념 단위의 특징을 찾아내는 연구가 어디까지 왔는가.
- 7장
레드팀과 적대적 평가
모델을 공격해 한계를 드러내는 절차가 개발의 정규 단계가 된 과정.
- 8장
에이전트와 실행 권한
AI가 도구를 쓰고 일을 끝낼 때 안전 문제가 어떻게 달라지는가.
- 9장
AI 사용 지표와 노동
직무 단위 사용 지표로 본 대체와 보완, 그리고 자료의 한계.
- 10장
자율규제와 거버넌스
스스로 규칙을 만들며 규제를 요구하는 태도는 모순인가 전략인가, 한국 제도 논의에 주는 시사점.